Servera öppna modeller till ditt team och dina appar från en enda server, på ett fast månadspris i stället för per token.
*Exklusive moms.
INGÅR I VARJE PLAN
Ollama hämtar öppna modeller och serverar dem bakom ett lokalt API. Ett enda kommando får igång Llama, Qwen, Gemma, DeepSeek eller gpt-oss. Endpointen på port 11434 talar OpenAI-formatet, så det mesta av befintlig klientkod pekar dit med ett byte av URL. Projektet är MIT-licensierat.
Open WebUI är chattgränssnittet som följer med i samma mall. Det sköter inloggningar, dokumentuppladdning för RAG och behörigheter per grupp. Det pratar dessutom med vilken OpenAI-kompatibel backend som helst, så Ollama behöver inte vara det enda bakom. Att köra båda på din egen VPS håller prompterna, de uppladdade dokumenten och modellvikterna på en disk du hyr i stället för en leverantörs.
Peka LangChain eller din egen Python-klient mot port 11434 så fungerar det.
Hämta DeepSeek, Qwen, Gemma eller gpt-oss och växla mellan dem på sekunder.
Ladda upp dokument, ge varje kollega en inloggning och bestäm vad de når.
Open WebUI ger alla en inloggning och ett gränssnitt de redan förstår, medan modellen körs på din server. Inget skickas till tredje part för träning. Administratören bestämmer vilka modeller varje grupp når.
Peka LangChain, en Python-tjänst eller ett IDE-plugin mot Ollamas API och byt base URL. Samma kod som körde mot en kommersiell leverantör fungerar vidare. Räkningen slutar skala med användningen.
Val av modell är egentligen en minnesfråga. Små kvantiserade builds ryms bekvämt i RAM på en CPU-server. Större releaser vill ha vRAM innan de blir användbara i samtalstempo. Börja litet, mät, och dimensionera sedan maskinen efter modellen du landar i.
Containerimagen håller runtime skild från allt annat på maskinen, vilket gör versionslåsning och rollbacks enkla. Den körs likadant på en vanlig VPS som på en Docker VPS med runtime redan installerat.
Agenter och workflows bränner tokens fort, och det är där en fast månadsserver börjar slå mätta API-anrop. En n8n-instans eller en OpenClaw-agent kan anropa din Ollama-endpoint på samma privata nätverk.
Inferens på CPU duger fint för små modeller och slutar snabbt duga ovanför det. En GPU VPS med full passthrough kör de större releaserna i samtalstempo. Det är samma konto, så att gå upp betyder inte att du bygger om något.
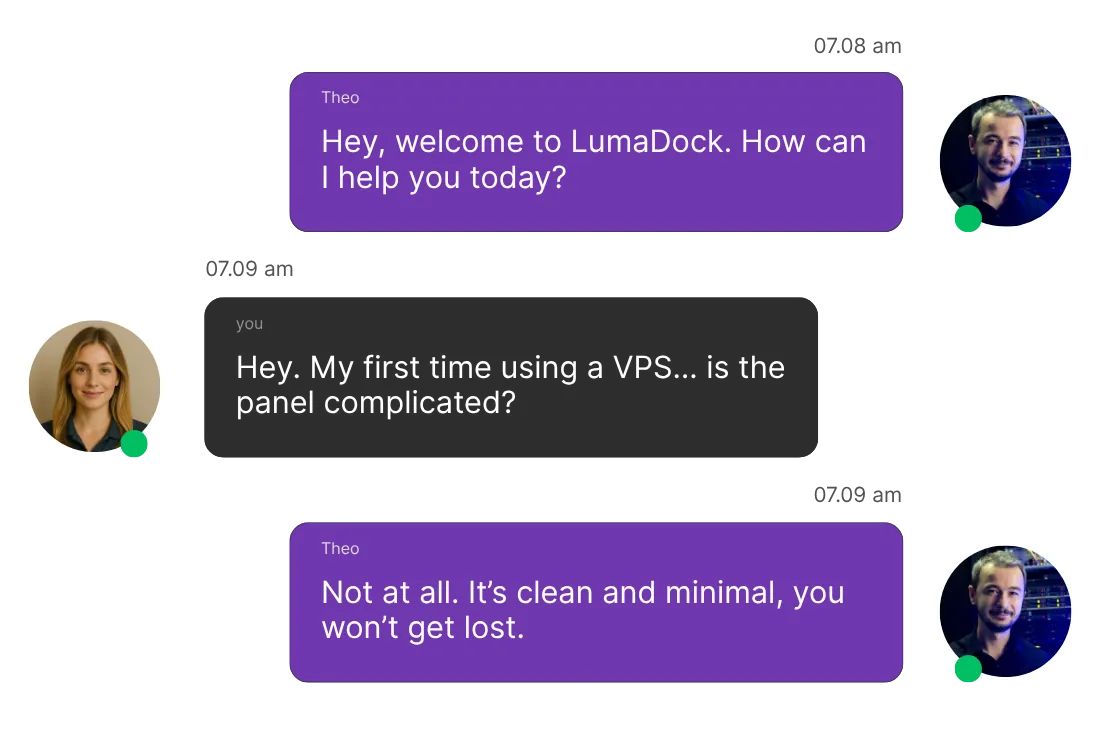
Distribuera vilken mall som helst och certifierade specialister täcker allt på servernivå, 24/7 och på flera språk. Det ingår i varje plan, förfinat under 17 år av att driva infrastruktur.
Prototypa på EPYC-kärnor med en liten kvantiserad modell och flytta sedan samma upplägg till en GPU VPS när det behöver riktigt vRAM. Allt ligger i ett konto och en kontrollpanel, så det finns ingen migrering att boka in.
Modellfiler går upp i tiotals gigabyte och ett seriöst bibliotek fyller en disk snabbt. Full root på KVM plus NVMe-lagring betyder att du bestämmer vad som hämtas, vad som rensas och med vilka runtime flags Ollama startar.
Att hämta en modell är en stor nedladdning. Att servera ett API till ett team är ett jämnt flöde. Trafiken är obegränsad på en 1 Gbps-port, så inget av dem dyker upp som en rad på fakturan.
Prompter och uppladdade dokument bor där servern bor, vilket väger tyngre vid inferens än vid det mesta man annars kör själv. Nio platser i Europa, Storbritannien och USA betyder att du väljer det redan i beställningen.

Bra pris för vad du får
2025-12-29"Jag har använt deras tjänster ett tag och det har varit riktigt bra. Prestandan är bra och pålitlig, och priset gör helheten ännu bättre. Allt bara funkar smidigt, och de svarar snabbt när man behöver något."
Fantastiskt team och företag
2025-03-01"Fantastiskt team och företag. I takt med att de gör sina tjänster tillgängliga i fler regioner i världen fortsätter de också att höja ribban på kvalitet och effektivitet."
Uppsättningen gick snabbt och...
2025-09-01"Uppsättningen gick snabbt och VPS:en har rullat utan problem sedan dess. Kundtjänsten svarade på mina frågor utan att krångla till det, och det uppskattade jag verkligen."
LumaDock erbjuder snabb och prisvärd VPS, GPU och dedikerad serverhosting för utvecklare, företag och gamers, driven av NVMe-lagring och AMD EPYC.
LumaDock® är ett registrerat varumärke som tillhör LumaDock LTD, med säte i London W1S 1HN, Storbritannien, och registrerat i England och Wales under företagsnummer 15844051.