Faites tourner une seule interface de chat pour OpenAI, Anthropic, Google et vos modèles locaux, l'historique restant sur votre disque.
*Hors TVA.
INCLUS DANS CHAQUE OFFRE
LibreChat est une interface de chat que vous faites tourner vous-même, pointée vers les modèles que vous payez déjà. OpenAI, Anthropic, Google, Azure, AWS Bedrock et n'importe quel endpoint compatible OpenAI coexistent, donc une conversation peut commencer sur un modèle et se poursuivre sur un autre. Le projet est sous licence MIT. ClickHouse l'a racheté en novembre 2025.
Ce qui change, c'est la destination de l'argent. Une offre au siège facture autant pour le collègue qui pose deux questions par semaine que pour celui qui y vit, tandis que LibreChat ne facture rien de lui-même et vous renvoie vers les API des fournisseurs. Deux choses à savoir avant de basculer. Les factures d'API restent les vôtres. Et le Code Interpreter hébergé est un service payant de LibreChat, pas un élément de l'installation auto-hébergée.
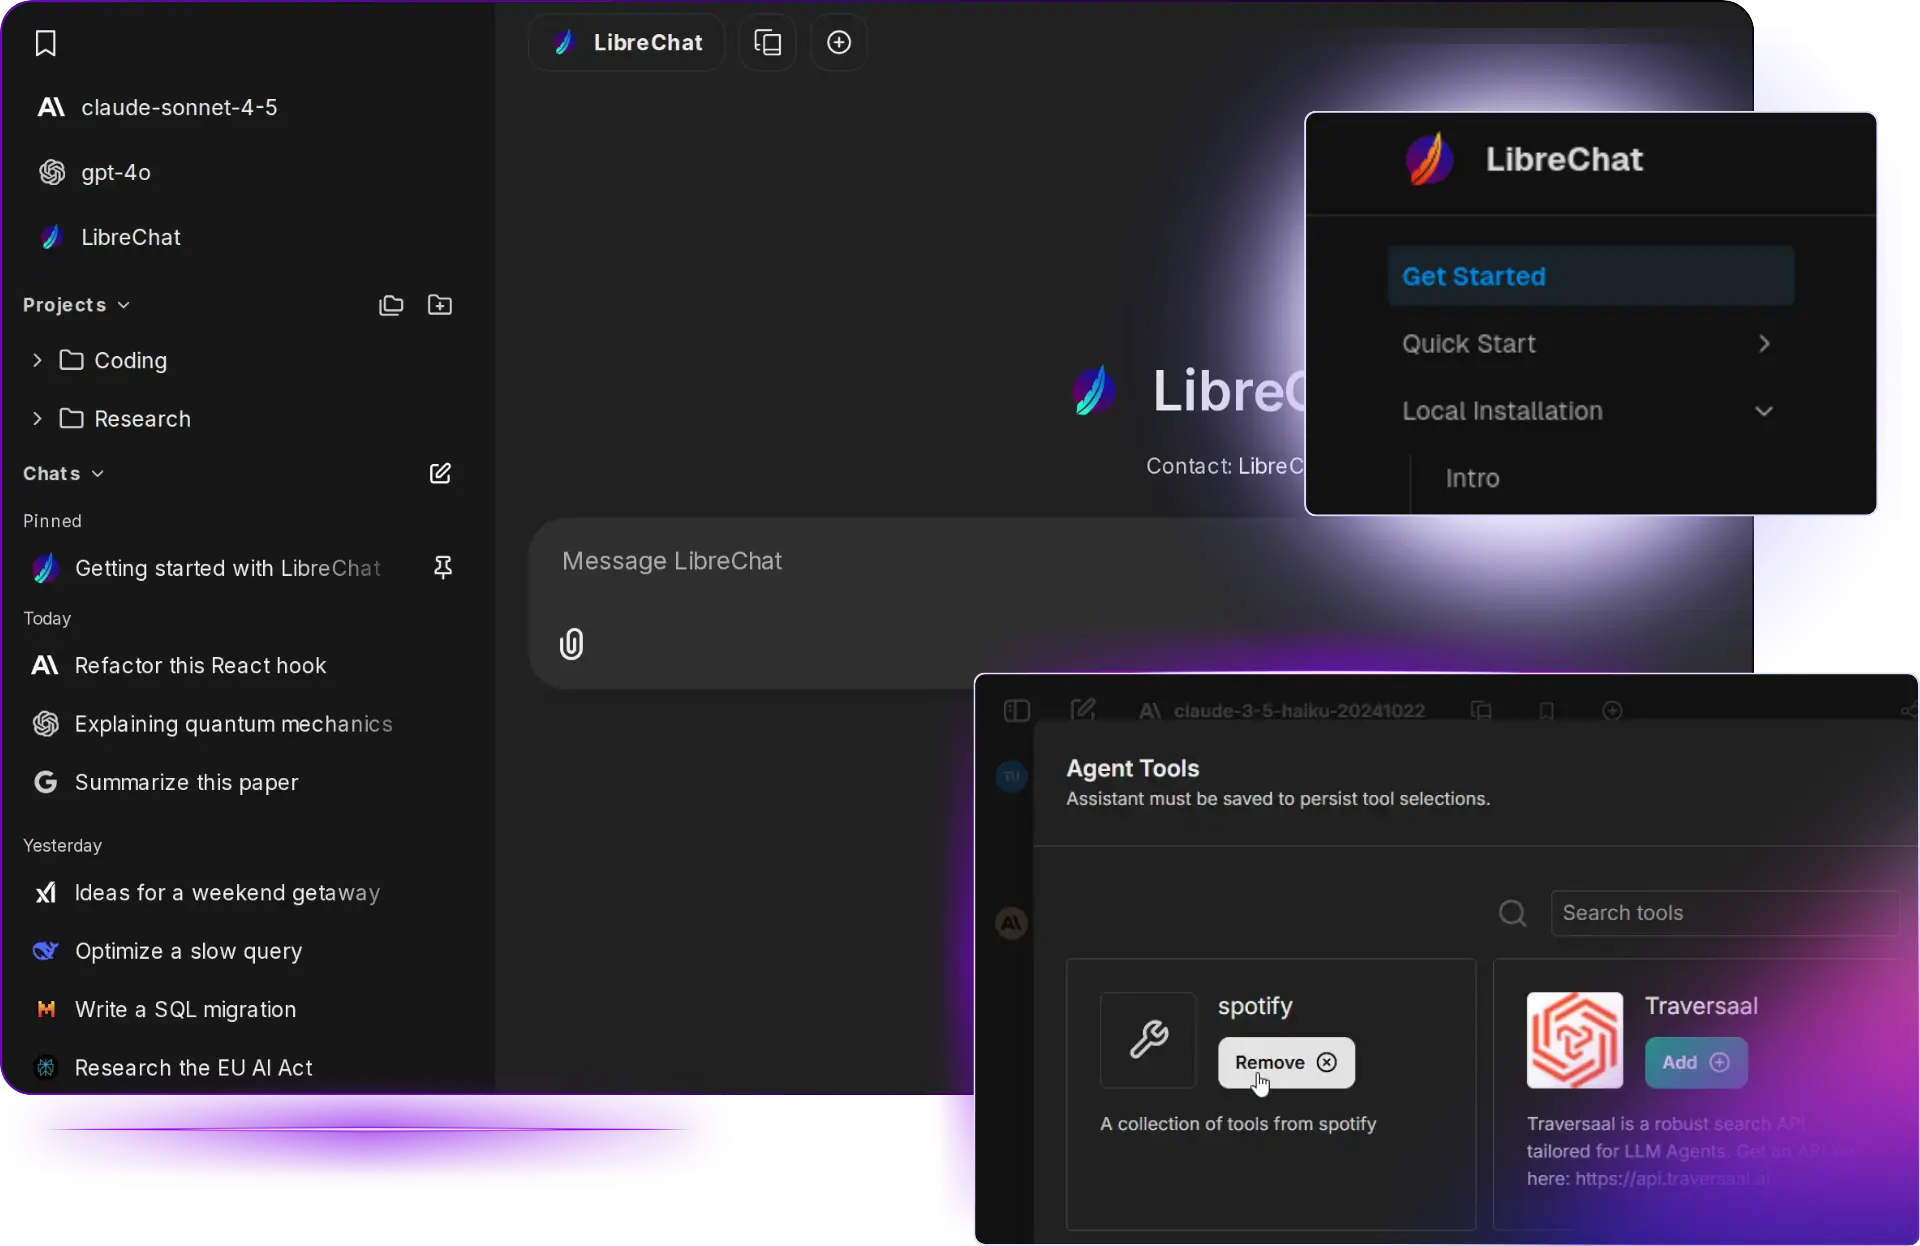
Construisez des assistants sans code et reliez-les à des outils via Model Context Protocol.
Chacun se connecte via l'annuaire que votre entreprise gère déjà.
Retrouvez n'importe quelle conversation passée, enregistrez une configuration et affichez du React ou du Mermaid dans le chat.
Chacun se connecte via le fournisseur d'identité que vous utilisez déjà, pendant que l'administrateur décide quels modèles chaque groupe peut atteindre. Les conversations vivent dans votre base de données et pas dans celle d'un éditeur, ce qui compte dès que des gens collent dans un chat des choses qu'ils n'enverraient jamais par e-mail.
Open WebUI penche vers les modèles locaux et une installation plus légère, donc il l'emporte quand Ollama est la pièce maîtresse. LibreChat devient plus fort dès que plusieurs fournisseurs payants, une vraie gestion des utilisateurs et des agents entrent en jeu. Si vous décidez pour une entreprise plutôt que pour vous-même, LibreChat est en général celui qui survit au contact d'une politique informatique.
Le changement de modèle se fait en pleine conversation, donc vous envoyez la même question à Claude et à GPT et comparez les réponses sans quitter le fil. Les préréglages enregistrent la configuration qui marchait, ce qui évite que tout le monde reconstruise la même chose.
Pointez LibreChat vers une API commerciale pour les questions difficiles et vers votre propre serveur Ollama pour les questions de routine. Le trafic bon marché cesse ainsi de toucher un endpoint facturé, et l'interface reste identique dans les deux cas.
Les équipes régulées ne peuvent souvent pas utiliser d'assistant hébergé du tout, parce que c'est précisément la transcription qui pose le problème de conformité. L'auto-hébergement déplace l'historique des conversations sur une infrastructure que vous pouvez montrer lors d'un audit.
Il se livre sous forme de Compose stack, avec sa base de données à côté de l'application, donc une mise à jour se résume à récupérer de nouveaux tags et redémarrer. Il se comporte pareil sur un VPS classique ou sur un Docker VPS où le runtime est déjà installé.
Déployez n'importe quel template et des spécialistes certifiés couvrent tout au niveau du serveur, 24/7 et en plusieurs langues. C'est inclus dans chaque offre, affiné en 17 ans d'exploitation d'infrastructure.
Un cœur et 2 GB font tourner l'interface sans effort, puisque les modèles vivent sur le matériel de quelqu'un d'autre. Pour la plupart des équipes, la facture du fournisseur écrase celle du serveur, ce qui fait de cette brique l'une des moins chères que vous déploierez cette année.
Vos identifiants de fournisseur se trouvent dans un fichier d'environnement sur un serveur avec root complet, plutôt que collés dans le tableau de bord d'un tiers. Et si une clé doit un jour être remplacée, c'est une modification de texte et un redémarrage.
Commencez avec des API commerciales, puis rapatriez le trafic de routine dès que le volume le justifie. Un serveur Ollama ou un GPU VPS se branche comme un endpoint de plus, le tout sous le même compte.
L'historique de chat est souvent la donnée la plus sensible qu'une équipe produit. La question du pays où il se trouve arrive plus vite qu'on ne l'imagine. Neuf emplacements en Europe, au Royaume-Uni et aux États-Unis veut dire que vous y répondez dès la commande.

Bon rapport qualité-prix
2025-12-29"J'utilise leurs services depuis un moment et c'est top. Les performances sont bonnes et fiables, et le prix rend le tout encore meilleur. Tout fonctionne sans accroc, et ils sont très réactifs dès qu'on a besoin de quelque chose."
Équipe et entreprise au top
2025-03-01"Équipe et entreprise au top. Au fur et à mesure qu'ils étendent la disponibilité de leurs services à d'autres régions du monde, ils continuent de progresser en qualité et en efficacité."
La mise en place a été rapide et...
2025-09-01"La mise en place a été rapide et le VPS tourne sans souci depuis. Le support client a répondu à mes questions sans compliquer les choses, et ça m'a honnêtement plu."
LumaDock propose un hébergement VPS, GPU et serveurs dédiés rapide et abordable pour les développeurs, les entreprises et les gamers, propulsé par du stockage NVMe et AMD EPYC.
LumaDock® est une marque déposée de LumaDock LTD, basée à Londres W1S 1HN, Royaume-Uni, et enregistrée en Angleterre et au pays de Galles sous le numéro de société 15844051.